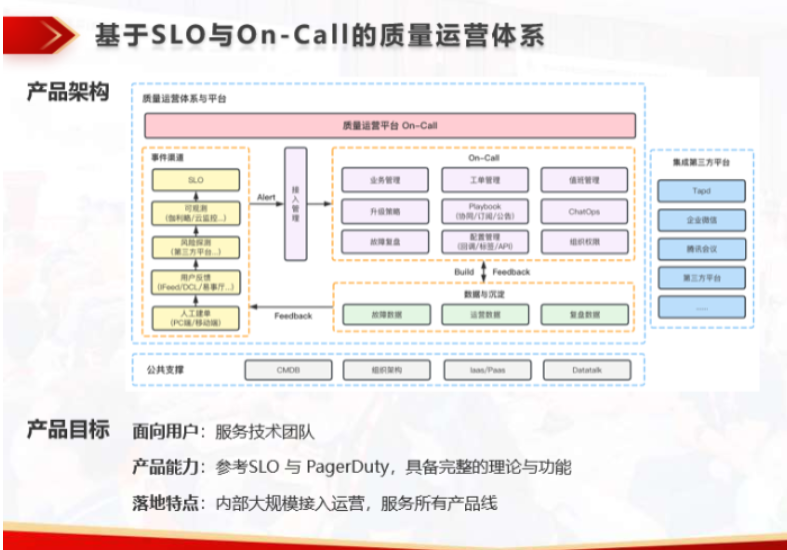
腾讯SRE(网站可靠性工程)质量运营体系的搭建和实际操作,重点是SLO(服务等级目标)和On-Call事件管理在腾讯内部是怎么玩的。这里详细分享了他们是怎么通过这些方法提高产品稳定性的经验和成果。
行业背景
从理论层面看,如何建设稳定性是个大问题。SLO和On-Call在业界已经有不少产品或解决方案,比如PagerDuty、Opsgenie、Grafana、Datadog、Google Cloud Monitor和Facebook的SLICK等等,主要涉及质量运营管理、研发过程管理、可视化和可观测领域。
从产品层面看,这些产品在SLO管理和简化版On-Call方面各有千秋。比如PagerDuty是On-Call的标杆产品,Opsgenie把研发管理延伸到On-Call,Grafana从可视化延伸到On-Call,Datadog和Google Cloud Monitor专注于可观测领域,Facebook的SLICK则用于内部SLO管理。
基于SLO和On-Call的质量运营体系
说到问题背景,产品稳定性没法量化,没法变成明确的组织管理目标来持续改进;故障过程不透明不可控,受团队或个人主观因素影响大,故障影响时间变长;传统方法不够先进,没用上DevOps方法论,研发和SRE团队协作不够,稳定性投入积极性不高。
在SLO管理方面,合理建立稳定性与功能迭代的评估关系,SRE和研发一起制定合理的质量目标,面向用户场景而不是系统,用错误预算燃烧告警和错误预算决策等方法。
在On-Call管理方面,通过On-Call事件管理,实现告警匹配、收敛、升级、恢复等功能,解决告警泛滥问题,提升故障处理效率。
在鹅厂的大规模落地实践
SLO管理实践:
核心场景与SLI指标:确定一级场景和二级场景,分别面向外部用户和内部用户的核心场景,每个技术团队确认职责边界,定义场景和SLI。
SLO目标与错误预算:目标设定的时间周期为28天(Google推荐),推荐目标通过自动计算历史周期给出,SRE主导,研发参与共同制定,面向用户,明确组织复杂情况下的使用者。
SLO应用:基于错误预算燃烧率的告警,比如某业务核心SLI成功率开始波动时,触发告警并快速响应。
建立SLO运营机制:已实现大规模接入,1000+业务场景,3000+SLO指标,聚焦核心场景与指标,降低SLO的配置成本,基于错误预算进行决策。
On-Call事件管理实践:
事件接入解决的问题:通过告警匹配、收敛、升级、恢复等措施,解决告警泛滥问题,减少告警绝对数量,实现告警治理和On-Call事件接入。
标准化定义渠道:自动发现或用户反馈的数据驱动提升故障自动发现,实现全渠道接入,持续观测与提升故障自动发现比例,数据置信度大大提升。
On-Call在研发流程中的定位:面向技术团队,包括toC用户、toB用户和内部用户的反馈处理,实现一站式管理各类事件。
运行案例:展示了On-Call事件管理在实际运行中的案例,如全渠道接入、故障自动发现比例提升等。
On-Call响应管理实践:
保证标准化执行:通过业务管理、值班管理、升级策略、工单管理等基础功能,保证On-Call标准化执行,覆盖MTTR全周期。
值班管理与升级策略:提升团队整体研发效率和故障处理效率,满足多级别和多层级的灵活性需求。
工单管理:串联大部分On-Call能力,实现事件的高效管理。
质量数据模型实践:
数据模型分阶段:围绕不同数据维度,包括SLO数据、运营数据、渠道数据和质量数据等,进行分阶段的数据管理。
数据决策与管理稳定性:基于以上数据进行管理决策,制定稳定性相关OKR,实现数据驱动的质量管理。
腾讯通过标准化的产品与运营,大规模推进SLO与On-Call质量运营体系的落地,客观描述产品稳定性,实现数据决策质量投入,科学解决产品稳定性建设问题。
展望:稳定性的提升是个复杂且需要长期投入的过程,未来将聚焦于SLO精细化运营,影响产品研发决策,延伸质量体系至研发过程(CI/CD),并在SRE稳定性建设方面投入更多资源,如质量数据、可观测、混沌、演习、容量、巡检、治理等,以持续提升产品和服务的稳定性与可靠性。
IT运维管理:ITIL先锋论坛—腾讯 SRE 质量运营体系建设与实践.pptx